 3分鐘研究室
ChatGPT 為什麼看得懂你?一次看懂 Transformer 和注意力
2017 年的論文 Attention Is All You Need 讓句子裡的每個字直接去看其他每一個字,再決定要注意誰。這個模型叫 Transformer,ChatGPT 名字裡的 T 就是它。高中生也看得懂的論文解說。
影片即將上片完整影片近期在 YouTube「3分鐘研究室」上片
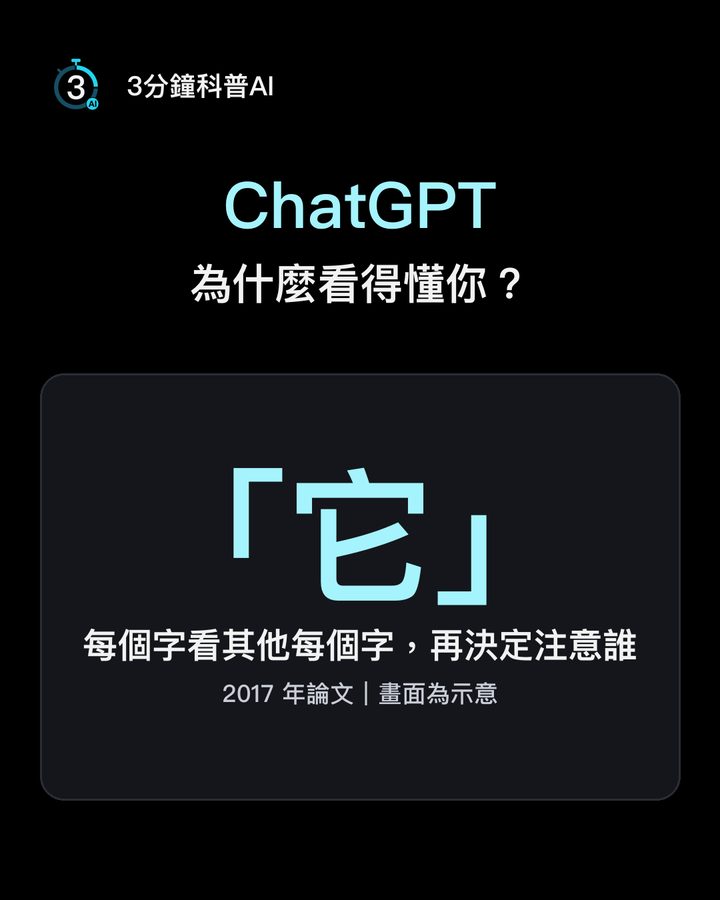
「獎盃放不進行李箱,因為它太大了。」你一秒就知道「它」是獎盃,可是電腦怎麼知道?答案藏在 2017 年一篇標題很短的論文:Attention Is All You Need,注意力就是你需要的全部。ChatGPT 裡面,也用到這篇論文提出的方法。
論文怎麼做
更早的時候,用神經網路做翻譯,是一個字一個字讀。不管句子多長,都要壓成同樣長的一串數字,再從這串數字翻出來。就像讀完一整段話,卻要把重點全塞進一張小便條。
2015 年另一篇論文(Bahdanau、Cho、Bengio,ICLR 2015)也證實:句子越長,這種做法翻得越差。它的解法是:翻每一個字的時候,回頭看原文,看哪幾個字比較重要,就多注意它們。這就是「注意力」。
2017 年,以 Google 為主的研究團隊更進一步:乾脆不要一個字一個字讀,整句話一次攤開,讓每個字直接去看其他每一個字。論文把這種模型取名叫 Transformer。
- 每個字都看全場: 用開頭的句子來想像,模型會讓「它」去看句子裡的每個字,算出該多注意誰。理想上,看到「太大」,注意力會比較偏向獎盃;換成「太小」,就應該改偏向行李箱。論文附錄也畫出,有兩組注意力看起來會把英文代名詞 its,連回它指的名詞。
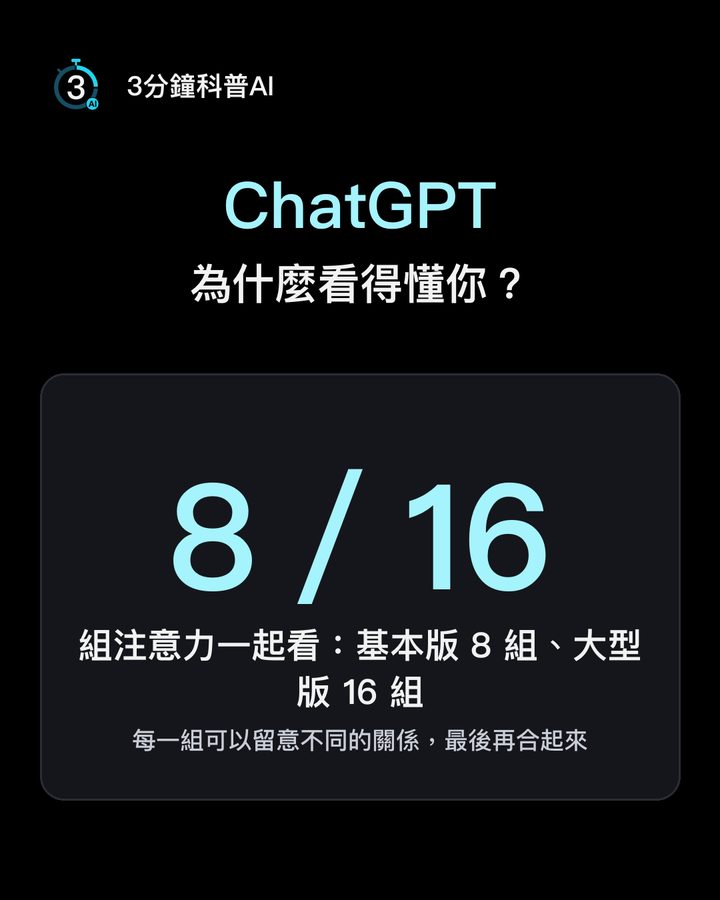
- 好幾組一起看: 同一時間有好幾組注意力一起看,論文的基本版用 8 組,大型版用 16 組,每一組可以留意不同的關係,最後再合起來。
- 位置標籤: 整句一次攤開,順序靠在每個字上加一個位置標籤,記得誰在前、誰在後。
結果
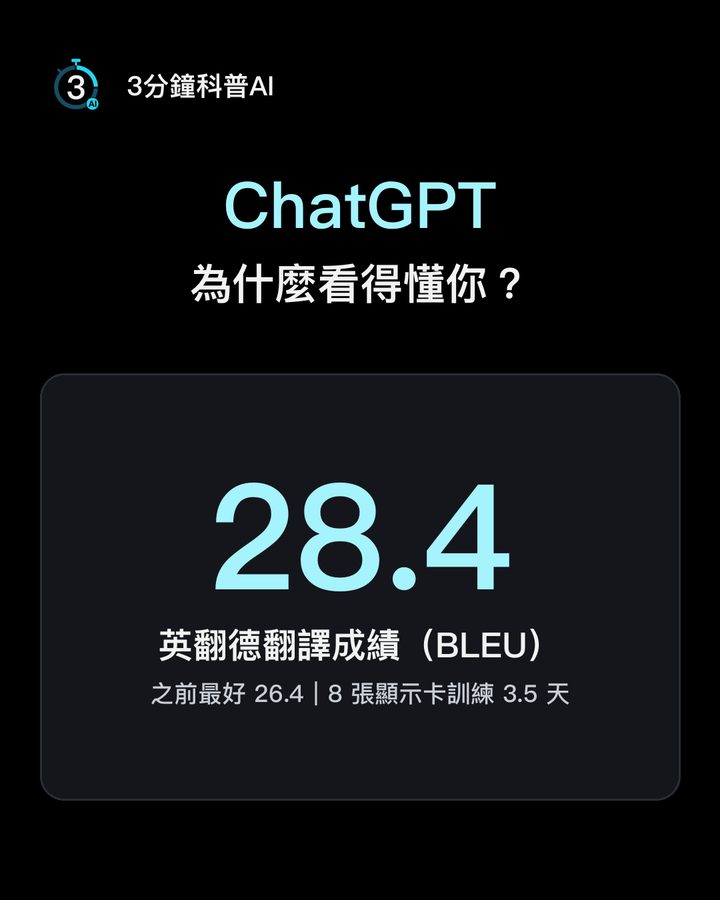
另一個大好處是快:一個字一個字讀必須排隊,整句一起看可以同時算。論文的大型版用 8 張顯示卡訓練 3.5 天,英翻德的翻譯成績(BLEU,越接近人工翻譯分數越高)從之前最好的 26.4 拉到 28.4,用的運算大約是那個最好結果的三分之一。
今天 ChatGPT 名字裡的 GPT,最後那個 T,就是 Transformer。
用三個問題來看
- 它解決了什麼問題? 一個字一個字讀,得排隊算、很慢,句子一長也容易漏掉前面的字。
- 今天的 AI 哪裡用到它? 聊天機器人、翻譯、寫程式的 AI,很多都建立在它上面。
- 它有什麼限制? 每個字都要看其他每個字,句子變兩倍長,注意力這部分的計算量大約變四倍,所以很長的文章很吃運算。
ChatGPT 能抓到你的意思,關鍵之一,就是每個字都在問:這句話裡,我該注意誰?
限制
- 這是給高中生看的簡化說明:論文的解碼器在產生翻譯時會遮住後面的字,不是每個字都能看到全部。
- 獎盃與行李箱的例子是示意,不是論文做過的實驗;畫面上的注意力粗細也是示意。
- 英翻法的成績論文前後寫法不一致(摘要 41.8、內文 41.0),本文不引用。
出處
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NIPS 2017). https://arxiv.org/abs/1706.03762
- Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. ICLR 2015. https://arxiv.org/abs/1409.0473
本文為論文解說,內容經過簡化,方便理解。